Sitemaps für das Web-Crawling
Frei zur öffentlichen Nutzung seit 2025.
- US 7,769,742 B1 USA verfallen 2019
- US 7,801,881 B1 USA verfallen 2019
- US 8,037,055 B2 USA erloschen 2025
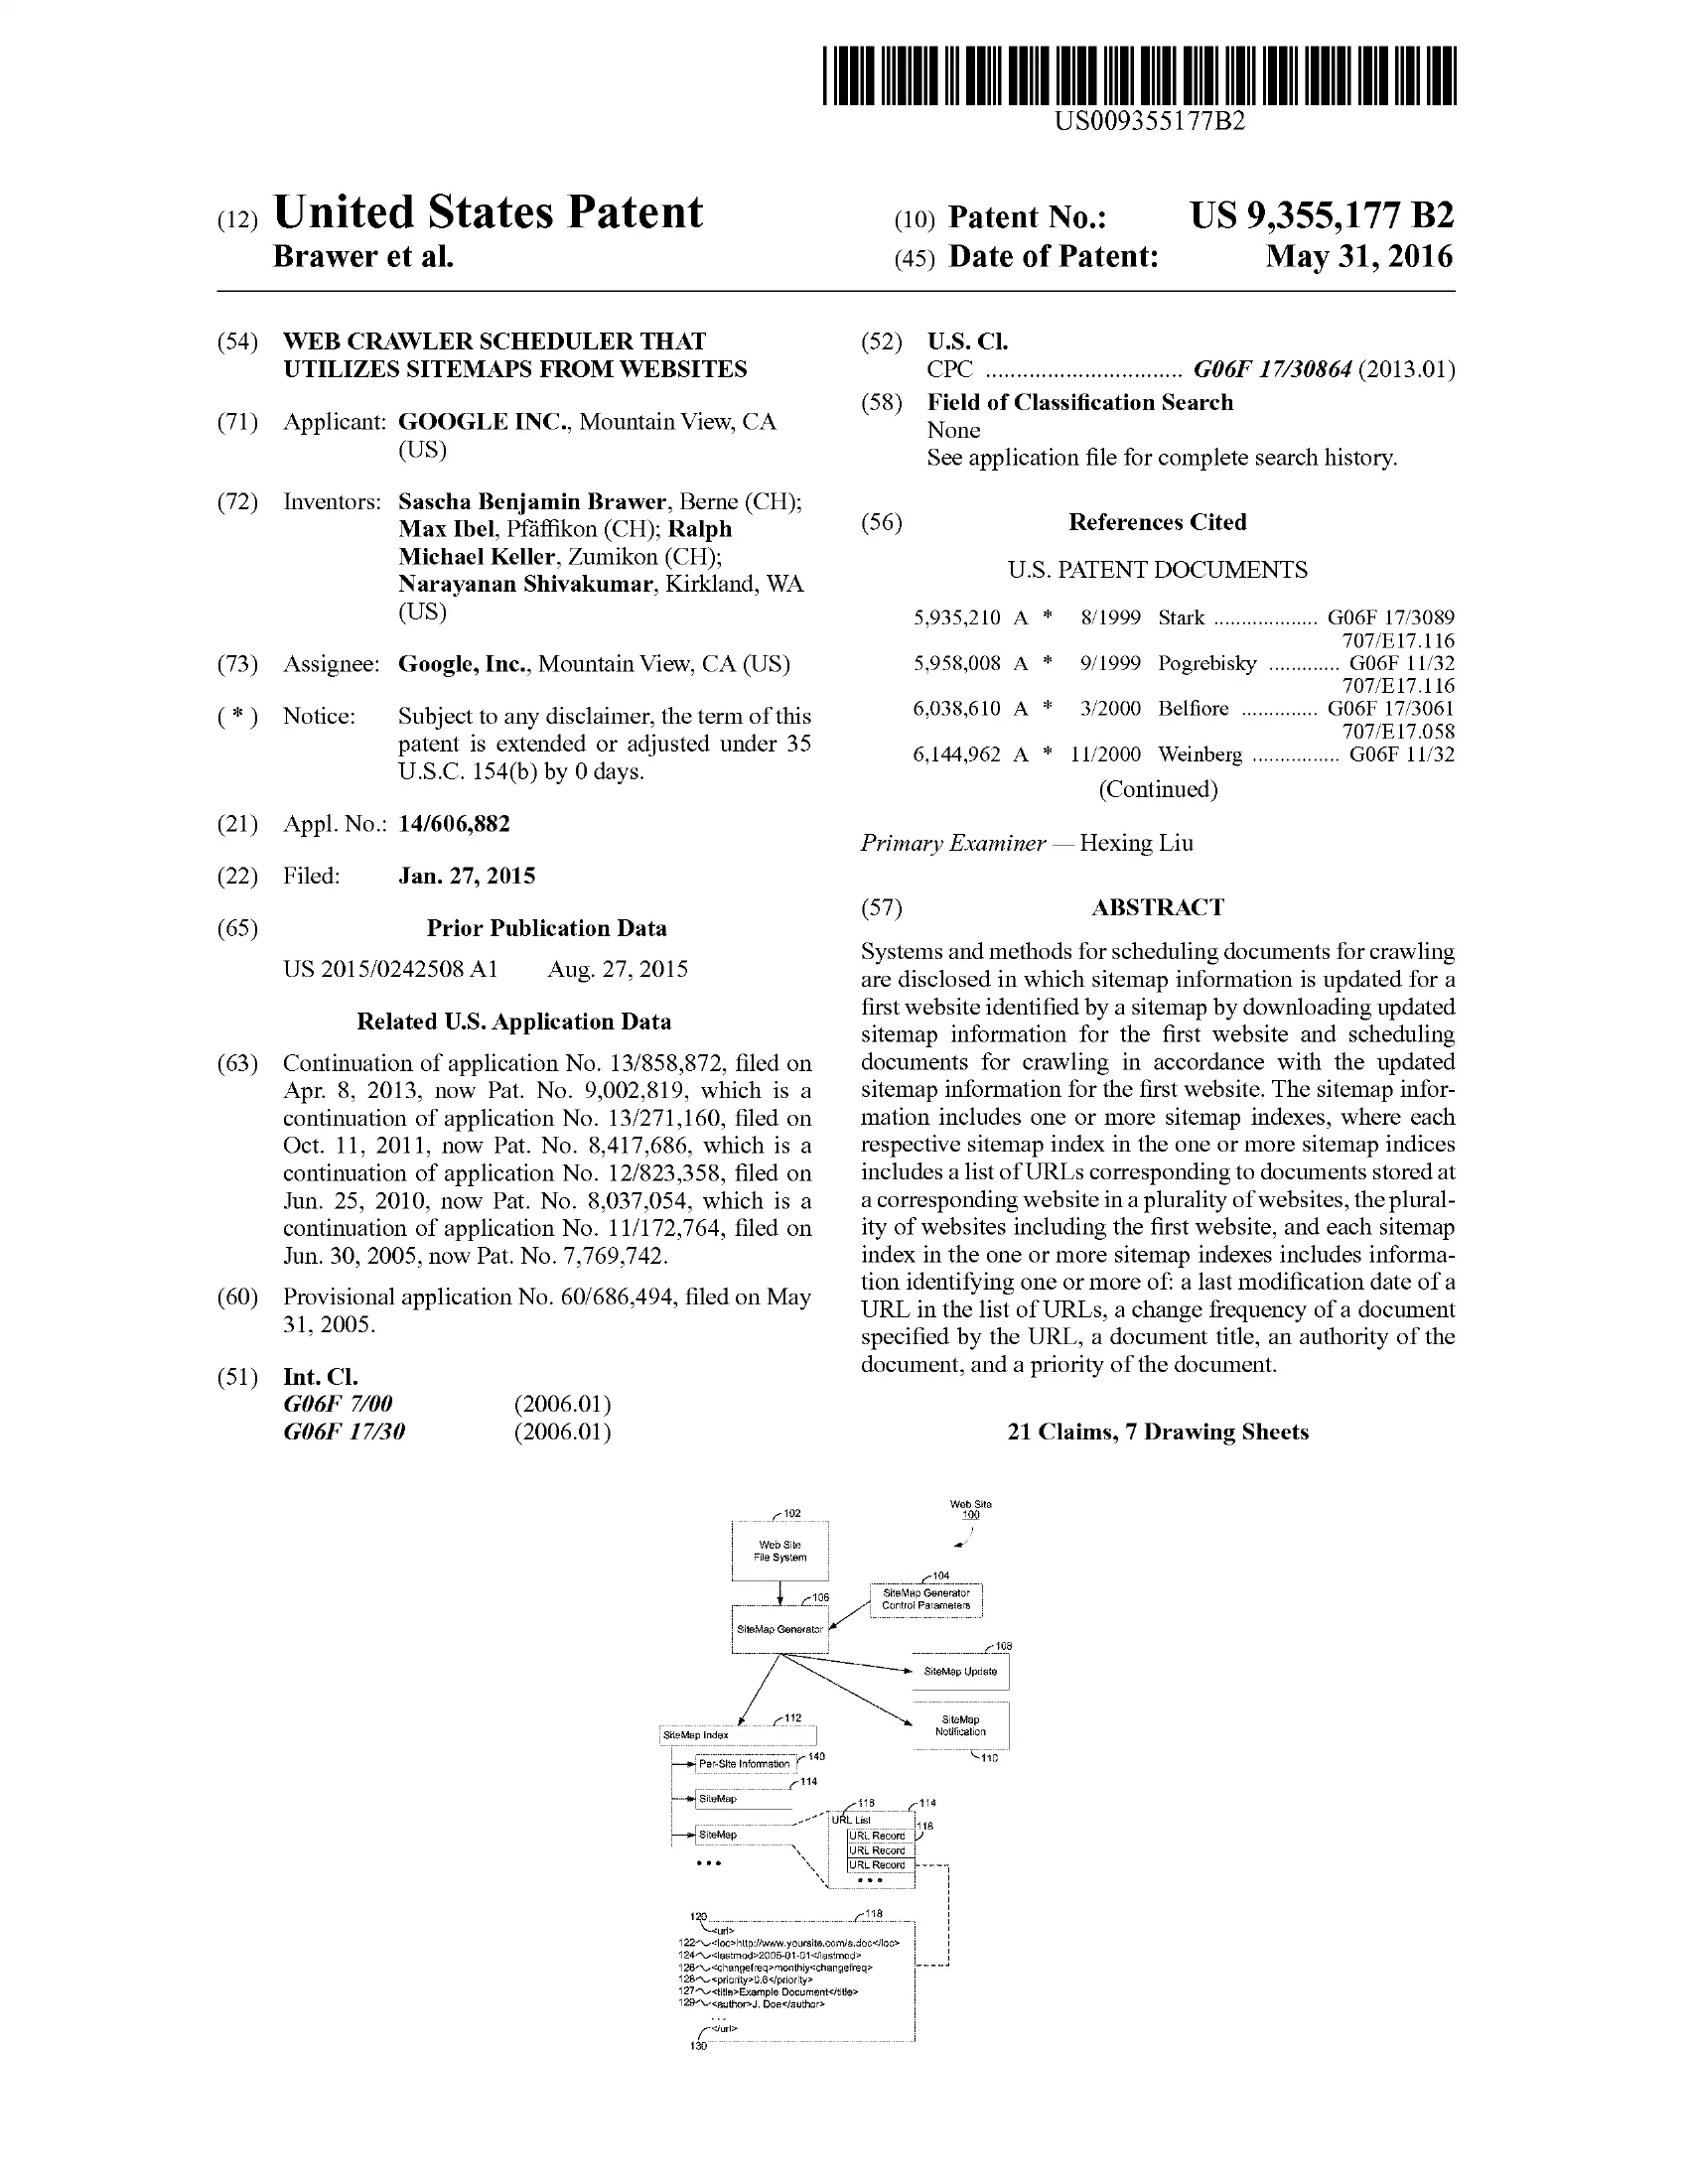
- US 9,355,177 B2 USA verfallen 2025
Zwei Seiten des Sitemaps-Mechanismus für das Crawling durch Suchmaschinen. Eine Website erzeugt eine XML-Datei, die ihre URLs samt Metadaten auflistet – Zeitpunkt der letzten Änderung, Änderungshäufigkeit, relative Priorität – und meldet den Suchmaschinen, dass diese Datei existiert. Ein Crawler liest diese Dateien dann, um Seiten zu finden, die er sonst übersehen würde, unveränderte Seiten auszulassen und die Lastgrenzen der Website einzuhalten, statt sich allein auf das Verfolgen von Links zu verlassen.
Die Patente hinter dem Sitemaps-Protokoll, das 2005 bei Google mitentwickelt und offen als Industriestandard veröffentlicht wurde – zwei US-Fortsetzungsstränge, einer für die Website-Seite und einer für die Crawler-Seite.